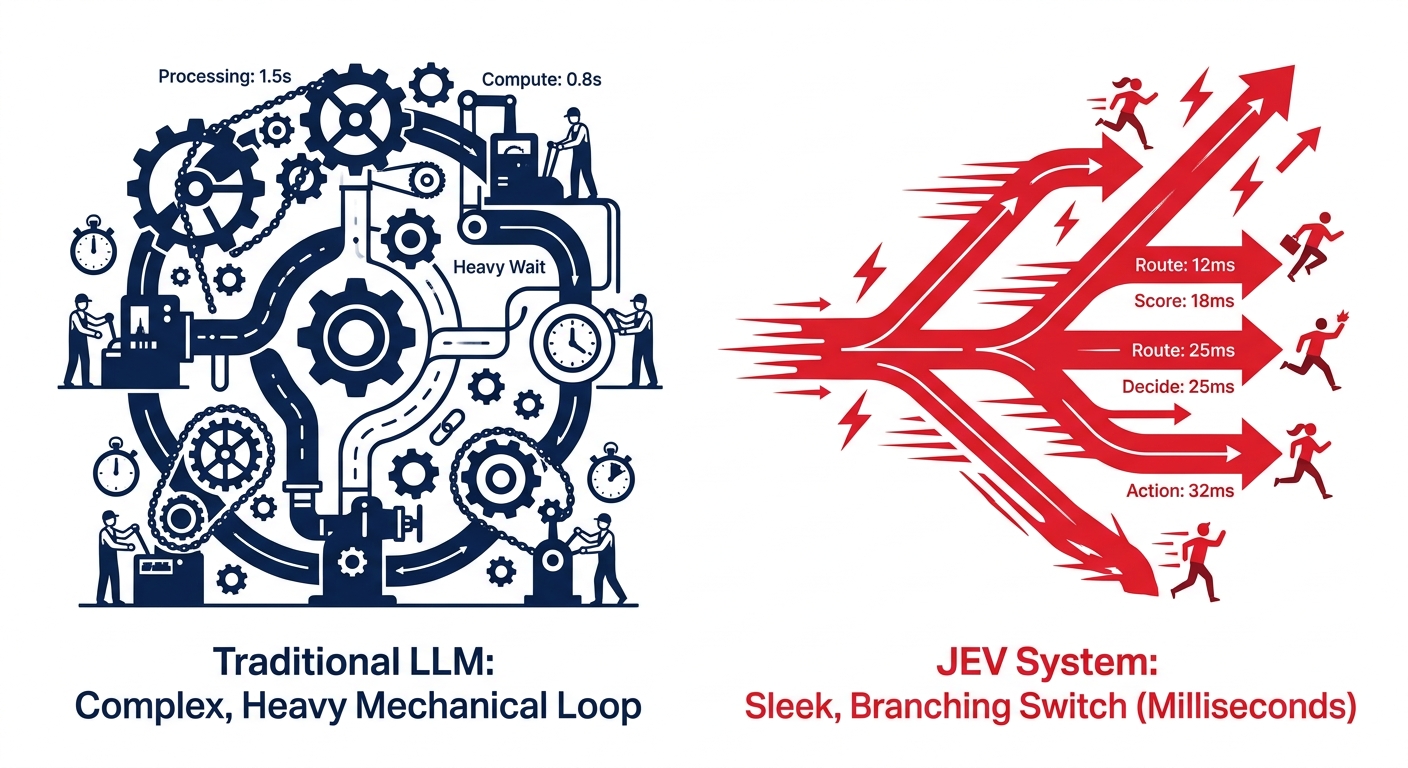
JEV od TypeSafe tworzy nową kategorię w architekturze AI — System One Models, czyli modele Systemu 1.
Do 193x szybsza praca i 444x niższe koszty w porównaniu do klasycznego wnioskowania w pętli agentowej.
JEV nie generuje tekstu — ocenia stan programu i zwraca typowaną decyzję: Choice, Score lub Bool.
Podział ról: kod liczy, LLM tworzy, JEV decyduje.
Przez lata budowanie zaawansowanych systemów agentowych przypominało przeciąganie ciężkiej lokomotywy parowej – każdy kolejny krok w pętli decyzyjnej wymagał pełnego wywołania dużego modelu językowego (LLM), generując paraliżujące opóźnienia i koszty.
Nowo zaprezentowany przez TypeSafe model JEV tworzy całkowicie nową kategorię w architekturze sztucznej inteligencji – tzw. System One Models (modele Systemu 1). Wyniki pierwszych testów benchmarkowych mówią same za siebie: do 193x szybsza praca i 444x niższe koszty w porównaniu do klasycznego wnioskowania w agentach opartych o modele takie jak Claude Fable 5.1 czy GPT-6 Astra. Dlaczego to podejście jest uznawane za punkt zwrotny na miarę narodzin sieci WWW?
Architektura „System 1” vs „System 2”: rewolucja na poziomie fundamentów
Tradycyjne modele LLM działają w trybie sekwencyjnym – wygenerowanie każdego kolejnego tokena tekstu nakłada znaczne narzuty obliczeniowe. Jest to odpowiednik ludzkiego, powolnego i analitycznego myślenia (System 2 w teorii Daniela Kahnemana).
JEV jest odpowiednikiem natychmiastowego, intuicyjnego podejmowania decyzji (System 1 — szybki i odruchowy):
- Brak generowania tekstu: JEV nie pisze odpowiedzi w języku naturalnym – jego rolą jest ocena stanu programu i zwrócenie ustrukturyzowanej, typowanej decyzji gotowej do natychmiastowego przetworzenia przez kod.
- Przetwarzanie równoległe w jednym przejściu: Zamiast generować odpowiedź token po tokenie, JEV ocenia wszystkie zdefiniowane zapytania i kaskady naraz.
- Kalibrowane prawdopodobieństwo: Każda decyzja zwraca precyzyjny wskaźnik pewności. System nie halucynuje wartości typów – zwraca czyste dane w schemacie (np. Choice, Score, Bool).
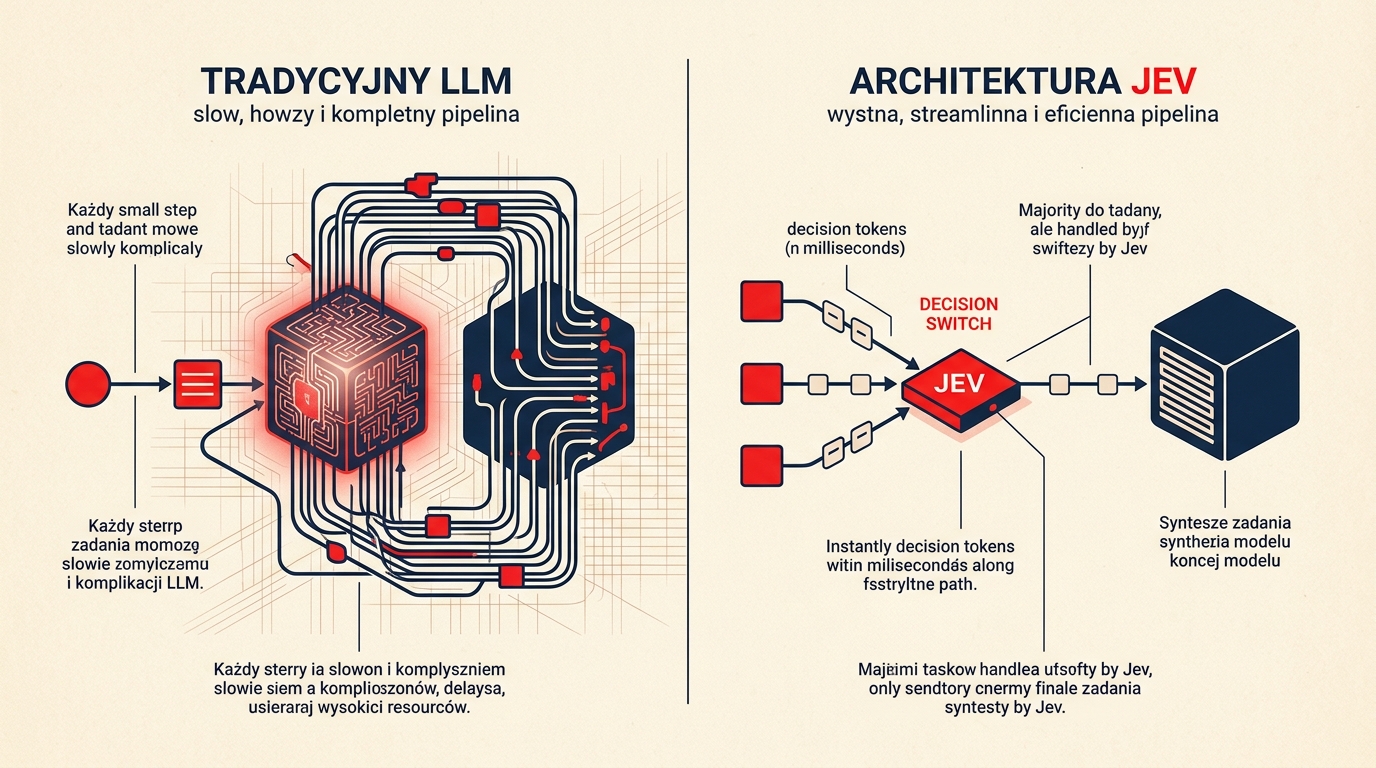
Wdrożenie JEV w pętli agentowej przypomina zastąpienie powolnego pociągu parowego szybką koleją magnetyczną.
Zamiast przy każdym rozgałęzieniu zadania uruchamiać kosztowny, sekwencyjny proces analityczny, system błyskawicznie podejmuje decyzję o kolejnym kroku, angażując ciężki model językowy dopiero wtedy, gdy wymagana jest synteza tekstu lub złożone rozumowanie.
10 kroków do przełomu: jak JEV rekonstruuje pętlę agentową?
Podejście do integracji JEV sprowadza się do 10 kluczowych reguł architektonicznych, które porządkują rolę modeli w chmurze:
Podział ról
LLM tworzy treść, Agenty wykonują akcje, natomiast JEV podejmuje decyzje o kolejnym ruchu.
Trzy prymitywy decyzyjne
Przekształcenie rozgałęzień na typy Choice (wybór kategorialny), Score (ocena w skali) oraz Bool (prawdopodobieństwo yes/no).
Bezinwazyjna podmiana
Architektura pozwala na budowę pętli na bazowych modelach OpenAI, Anthropic czy xAI, a następnie wpięcie JEV jako warstwy decyzyjnej bez przebudowy całego grafu.
Struktura wykonawcza
Praca w oparciu o współdzielony stan, równoległe decyzje, progi ryzyka oraz kolejkę wykonania.
Grupowanie decyzji
Przeprowadzanie grupowych zapytań o stan – zamiast 13 sekwencyjnych pytań, jednorazowe wywołanie działa do 10x szybciej i 12,2x taniej.
Wpięcie na granicy rozgałęzień
Umieszczenie JEV na wąskich przewężeniach pętli: wyznaczanie narzędzia, modelu, akcji przeglądarkowej czy przekazania zadania człowiekowi.
Pomiar całej pętli, nie pojedynczych wywołań
Mierzenie wydajności i kosztu pełnej pętli agentowej, a nie pojedynczych wywołań API.
Sortuj szeroko, czytaj wąsko
Szybkie odfiltrowywanie i sortowanie dużego zbioru opcji, aby moc obliczeniową dużych modeli zużywać wyłącznie na najistotniejszym wycinku.
Uniwersalny cykl pracy
Sprowadzenie działania do stałego schematu: Stan → Zapytanie → Akcja → Weryfikacja.
Ścisła separacja
Wyłączenie JEV z zadań matematycznych, pisania tekstów oraz nieodwracalnej egzekucji. Kod liczy, LLM tworzy, JEV decyduje.
Porównanie podejść z JEV w budowie agentów AI
| Cecha / Wskaźnik | Pętla oparta wyłącznie o LLM | Pętla hybrydowa z wykorzystaniem JEV |
|---|---|---|
| Czas odpowiedzi | Sformatowanie i wygenerowanie odpowiedzi: od 3 do 30 sekund. | Błyskawiczna ewaluacja stanu: od 70 do 500 milisekund. |
| Błędy struktury i typów | Ryzyko błędnego JSON-a lub niepoprawnego wywołania narzędzia. | 0% błędów typowania (praca na zdefiniowanym schemacie). |
| Wykorzystanie budżetu | Liniowy lub wykładniczy wzrost kosztów wraz z długością pętli. | Radykalne cięcie kosztów dzięki równoległemu grupowaniu pytań. |
| Kalibracja pewności | Częsta nadmierna pewność siebie modelu. | Precyzyjny wskaźnik prawdopodobieństwa pozwalający na autoselekcję. |
Nowy model LLM JEV: wnioski dla wdrożeń AI w organizacjach
Pojawienie się architektury Systemu 1 jednoznacznie wyznacza kierunek rozwoju inżynierii AI: przyszłość nie polega na ślepym przepychaniu całego kontekstu przez najdroższe modele generatywne. Przejście od wolnych pętli agentowych do ultraszybkich systemów decyzyjnych pozwala na budowę skalowalnych produktów, w których czas reakcji mieści się w milisekundach, a koszty utrzymania przestają być barierą biznesową.
Chcesz obniżyć koszty wnioskowania w swoich modelach LLM przy wykorzystaniu JEV? Porozmawiaj z nami.
Najczęstsze pytania
Czym jest JEV i czym są System One Models?
JEV to zaprezentowany przez TypeSafe model tworzący nową kategorię architektury AI — System One Models. Nie generuje tekstu w języku naturalnym: ocenia stan programu i zwraca ustrukturyzowaną, typowaną decyzję gotową do natychmiastowego przetworzenia przez kod.
O ile JEV jest szybszy i tańszy od klasycznego wnioskowania LLM?
Wyniki pierwszych testów benchmarkowych mówią o pracy do 193x szybszej i kosztach do 444x niższych w porównaniu do klasycznego wnioskowania w agentach opartych o duże modele językowe. Samo grupowanie decyzji (batching) działa do 10x szybciej i 12,2x taniej niż sekwencyjne zapytania.
Czy wdrożenie JEV wymaga przebudowy istniejącego systemu agentowego?
Nie. Architektura pozwala zbudować pętlę na bazowych modelach OpenAI, Anthropic czy xAI, a następnie wpiąć JEV jako warstwę decyzyjną bez przebudowy całego grafu.
Do jakich zadań nie należy używać JEV?
Do zadań matematycznych, pisania tekstów oraz nieodwracalnej egzekucji. Obowiązuje ścisła separacja ról: kod liczy, LLM tworzy, JEV decyduje.